Fahrzeugdaten aus der Praxis als wiederverwendbare Ressource für Entwicklung und Absicherung
30. Oktober 2026 | Daniel Zalghout | 4 Min.
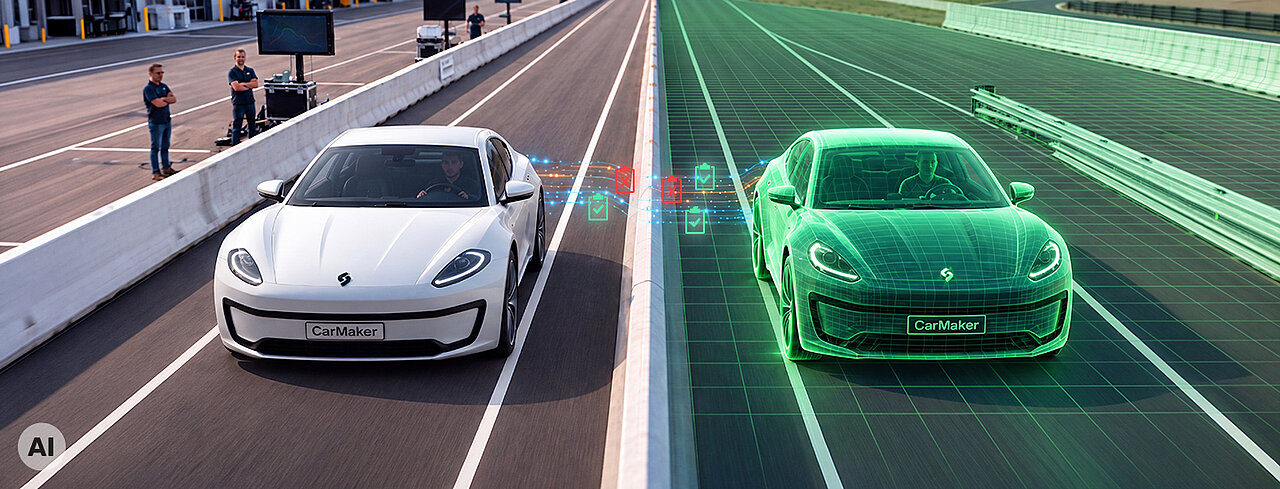
Jahrelang folgte die Automobilbranche dem einfachen Grundsatz: Wer die meisten Testkilometer sammelt, liegt im Bereich automatisiertes Fahren vorn. Heutzutage unterhalten Unternehmen, die im Bereich Engineering tätig sind, riesige Server mit aufgezeichneten Fahrversuchen, doch es gibt nach wie vor Engpässe bei der Absicherung. Dabei liegt die Ursache auf der Hand: Der Branche mangelt es nicht an Daten, sondern an wiederverwendbaren Ressourcen für die Absicherung.
In den meisten Fällen werden Aufzeichnungen aus Testflotten lediglich als einmalige Testnachweise betrachtet. Ein Testlauf wird aufgezeichnet, um eine Straßenfahrt zu dokumentieren oder eine einzelne Anomalie zu untersuchen. Anschließend wird er auf einem Datenserver archiviert und nie wieder angerührt. Währenddessen haben Entwicklungsteams Probleme damit, wichtige Grenzfälle in Rohaufzeichnungen zu identifizieren, konsistente Metadaten zu verwalten, saubere Datensätze für KI aufzubereiten und Anomalien im Labor deterministisch zu reproduzieren.
Um diesen Engpass zu überwinden, ist ein strategischer Umbruch erforderlich: Reale Daten sollten nicht nur als Testnachweis herangezogen werden. Sie sollten zu einer wiederverwendbaren Ressource für KI-Training, Szenariengenerierung, Replay, Simulation und Absicherung über den gesamten Entwicklungszyklus hinweg werden.
Warum dieses Problem in den Bereichen ADAS und automatisiertes Fahren besonders akut ist
Die Komplexität moderner Fahrzeugsysteme nimmt viel schneller zu, als sie durch reale Tests bewältigt werden kann. Zukünftige Architekturen für ADAS und automatisiertes Fahren vereinen ein Sensorpaket mit einer komplexen Steuerlogik und Perzeptionsmodellen.
Klassische Fahrversuchsstrategien können den neuen Anforderungen nicht gerecht werden, da sie sich nicht in dem erforderlichen Maße skalieren lassen. In der realen Welt ist eine nahezu unendliche Kombination von Straßenverläufen, Wetterbedingungen und Verkehrsinteraktionen möglich. Wenn ein Perzeptionsmodell neu trainiert oder ein Bewegungsplaner aktualisiert wird, ist es in der realen Welt unmöglich, identische Bedingungen zu schaffen, um die Funktionalität zu überprüfen. Ohne einen systematischen Ansatz zur Umwandlung realer Fahrzeugdaten in zugängliche, wiederverwendbare Ressourcen für die virtuelle Absicherung werden Entwicklungsteams mit immer längeren Fehlerbehebungszyklen, fragmentierten Toolketten und kritischen Sicherheitslücken konfrontiert.
Datengetriebene Entwicklung im richtigen Kontext betrachten
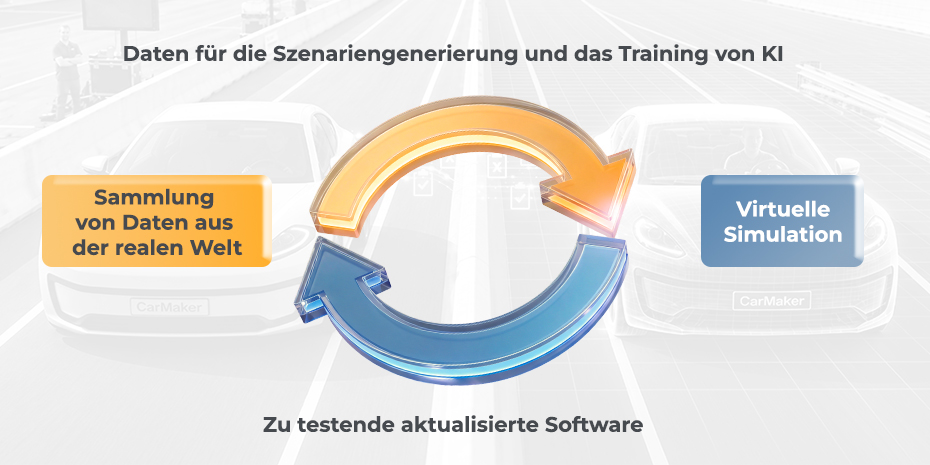
Bei der datengesteuerten Entwicklung geht es nicht darum, den Cloud-Speicher zu erweitern. Es geht darum, eine deterministische Pipeline zu etablieren, die den realen Fahrzeugbetrieb und die virtuelle Entwicklung miteinander verknüpft. In der Praxis erfordert dies die Kombination zweier wesentlicher Standardtestverfahren:
- Open-Loop-Tests (Wiedergabe und Fehlerbehebung): Die aufgezeichneten Sensor- und Busdatenströme werden in ihrer ursprünglichen zeitlichen Abfolge in Software oder physische Steuergeräte eingespeist. Dies ermöglicht eine sofortige Reproduzierbarkeit, sodass Ingenieur*innen die Ursache isolieren und Softwarefehler im Labor beseitigen können.
- Closed-Loop-Tests (szenarienbasierte Simulation): Die Wiedergabe im Open-Loop stößt an ihre Grenzen, sobald sich das zu testende System anders verhält als in der ursprünglichen Aufzeichnung, z. B. wenn früher gebremst oder ausgewichen wird. Da sich statische Logdaten nicht an eine neue Trajektorie anpassen können, muss der Test auf eine dynamische Simulation umgestellt werden. Durch die Simulation des Ereignisses in einem virtuellen Szenario mit virtuellen Fahrzeugprototypen und Sensormodellen kann das System mit seiner Umgebung interagieren und entsprechendes Feedback erhalten.
Die Verknüpfung beider Standardmethoden ermöglicht den nahtlosen Wechsel zwischen Wiedergabe und szenarienbasierten Tests, wodurch eine intakte, durchgängige Toolkette über den gesamten Validierungszyklus hinweg entsteht.
Durchgängiger Workflow
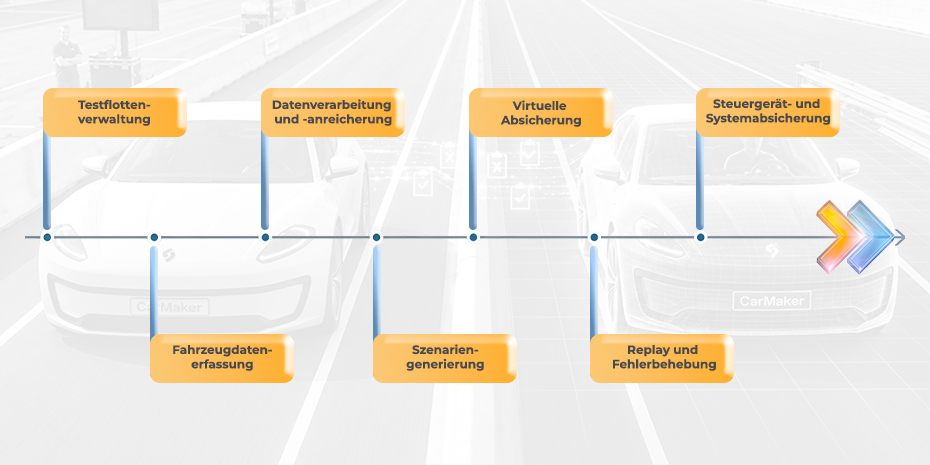
Die Umwandlung von Rohdaten aus dem Straßenverkehr in skalierbare Ressourcen für die Absicherung basiert auf einer integrierten, vierstufigen Prozesskette:
- Erfassen: Der Prozess beginnt mit dem Management flottenweiter Testkampagnen und der Erfassung von Fahrzeug- und Sensordaten mit hoher Bandbreite. Die zeitlich synchronisierte Datenerfassung über Fahrzeugbusse, Seriensensoren und Referenzmessgeräte hinweg gewährleistet hochpräzise Referenzdaten ohne Signalverlust oder Zeitabweichungen.
- Anreichern: Ohne Struktur haben Rohbinärdateien nur einen begrenzten Mehrwert. Durch automatisierte Datenverarbeitung und Qualitätssicherung werden die Signalintegrität überprüft und fehlerhafte Testläufe herausgefiltert. Über eine automatisierte Annotation und strukturiertes Metadatenmanagement werden die Szenen anschließend nach Fahrmanövern, Straßentypen und Objektinteraktionen klassifiziert, wodurch durchsuchbare Datensätze für das KI-Training erstellt werden können.
- Virtualisieren: Algorithmen zur Extraktion von Szenarien überführen aufgezeichnete Trajektorien und Umgebungsbedingungen in realistische virtuelle Szenarien. In Kombination mit virtuellen Fahrzeugprototypen und Sensormodellen können Teams synthetische Datensätze erzeugen, um Szenarien abzudecken, die bei Flottentests in der realen Welt nur selten auftreten.
- Validieren: Wiederverwendbare Ressourcen kommen in der Absicherung mit Software-in-the-Loop (SIL), Hardware-in-the-Loop (HIL) und vollständigen Steuergeräten zum Einsatz. Durch die Einspeisung von Sensor- und Busdaten in virtuelle Modelle und physische Hardware lassen sich in jeder Entwicklungsphase reproduzierbare Tests durchführen.
Wie Probleme aus der Praxis zu wiederverwendbaren Testfällen werden
Überlegen wir uns einmal, wie mit diesem Workflow ein realer Grenzfall gelöst werden kann: Bei starkem Regen kommt es in der Nähe einer Baustelle auf der Autobahn bei einem Flottenfahrzeug zu einer unerwarteten Phantombremsung. In einem isolierten Workflow würde die Fehlerdiagnose langwieriges manuelles Durchsuchen von Logdaten erfordern, gefolgt von nicht aussagekräftigen Versuchen, das Ereignis auf öffentlichen Straßen zu reproduzieren. Im Gegensatz dazu wird diese singuläre Anomalie in einer integrierten Pipeline zu einer wichtigen Ressource:
- Sofortige Wiedergabe: Anhand der angereicherten Metadaten lässt sich die Aufzeichnung genau lokalisieren, sodass Ingenieurteams die Sequenz über eine Open-Loop-Einspeisung wiedergeben und so den Fehler in der Perzeptionslogik schnell beheben können.
- Szenario-Variation: Der Straßenverlauf und die Verkehrstrajektorien werden in ein virtuelles Szenario überführt. Durch die Variation von Regenintensität, Fahrzeugabständen und Beleuchtung werden synthetische Daten generiert, um Modelle neu zu trainieren und die Robustheit des Reglers im Closed-Loop zu überprüfen.
- Regressionstests für die Absicherung: Das Szenario wird in automatisierte SIL- und HIL-Testpipelines integriert, wodurch Regressionstests für zukünftige Software-Releases abgedeckt werden, ohne dass zusätzliche Testfahrten erforderlich sind.
Ein weiterer Vorteil ist, dass sich diese Architektur nahtlos in bestehende Absicherungsumgebungen integrieren lässt – somit bleiben bisherige Infrastrukturinvestitionen erhalten.
Strategischer Ausblick
Durch den Fortschritt bei automatisierten Fahrsystemen sowie immer strengere regulatorische Anforderungen verändert sich selbstverständlich auch die Wirtschaftlichkeit der Automobilentwicklung. Der Wettbewerbsvorteil liegt nicht mehr darin, die meisten Daten zu sammeln, sondern vielmehr darin, die Daten am effizientesten in Wissen für die Entwicklung und Absicherung umzuwandeln.
Indem die Datenerfassung in der realen Welt mit der virtuellen Simulation verbunden wird, kann die Entwicklungsgeschwindigkeit deutlich gesteigert werden. Durch das Zusammenspiel von Flottenmanagement, Erfassung mit hoher Bandbreite, automatisierter Anreicherung und Closed-Loop-Simulation in einer durchgängigen Pipeline können Unternehmen die Absicherung effizient skalieren und gleichzeitig den Aufwand für die Fehlerbehebung reduzieren. Letztendlich schafft die datengetriebene Entwicklung so eine kontinuierliche Feedbackschleife zwischen dem realen Betrieb, KI-Training, virtueller Absicherung und Systemtests.
Über den Autor
Daniel Zalghout, Application Engineer bei IPG Automotive
In seiner Funktion als Application Engineer bei IPG Automotive verfügt Daniel Zalghout über Erfahrung in den Bereichen Hardware-in-the-Loop-Tests, Simulation und Softwarevalidierung. Vor Beginn seiner Tätigkeit bei IPG Automotive France im Jahr 2024 war er als Simulationsingenieur bei FEV Software and Testing Solutions sowie als leitender Software-Validierungsingenieur für Alpine in der Formel E und der Formel 1 tätig. Er hat einen Master-Abschluss in Powertrain Engineering von der IFP School, mit den Schwerpunkten Elektrofahrzeuge, Simulation und Modellierung sowie einen Bachelor-Abschluss in Maschinenbau von der Lebanese American University.
Sie wollen auf dem Laufenden bleiben?
Abonnieren Sie unser Blog-Update, um neue und spannende Artikel zu lesen.